> ## Documentation Index
> Fetch the complete documentation index at: https://docs.siflow.cn/llms.txt
> Use this file to discover all available pages before exploring further.
# 使用自动容错恢复训练任务
> 了解训练任务自动容错的工作机制、容错模式、故障类型和重试链,判断任务是否已从 checkpoint 恢复。
自动容错适合长时间训练任务,用于在节点、进程或通信异常时自动重试任务,减少人工值守。训练进度能否恢复,取决于训练程序是否把 checkpoint 写入持久化 Volume,并在新尝试中正确加载。
## 自动容错如何工作
自动容错通常按以下链路工作:
1. **健康检测**:平台监测进程退出、GPU / 硬件错误、通信挂起等异常,并根据日志和错误信息做故障分类。开启容错后,平台通常会在训练正式开始前执行启动前健康检测,用于提前发现节点或通信环境异常。
2. **故障处置**:根据故障类型尝试原地重启、重新提交、隔离疑似故障节点或触发二分诊断等动作;具体支持范围以当前平台能力为准。
3. **自动重试**:在最大重试次数内拉起新的重试任务,形成原任务和各次重试任务组成的容错重试链。
## 选择容错模式
基础容错可用于 PyTorchJob 和 RayJob;容错策略和 Hang 检测主要面向 PyTorchJob。具体可选项以创建训练任务时的 **高级选项** 为准。
| 模式 | 能力边界 | 使用建议 |
| -------------------------------------- | -------------------------------------------------------------------- | ------------------------------------ |
| 基础模式:只开启 **自动容错** | 任务失败后自动重新提交,最多重试到配置的次数。该模式通常不能识别任务“看起来运行中但没有进展”的卡住问题。 | 适合先获得基础重试能力,或对误判比较敏感、不希望开启更激进策略的任务。 |
| 进阶模式:**自动容错** + **容错策略** | 平台会根据报错信息判断故障类型,并尝试更合适的处理方式,例如原地重启或重新提交。若进程完全卡死且没有报错退出,仍可能无法发现。 | 适合长时间训练、希望平台根据故障类型自动恢复的任务。 |
| 完整模式:**自动容错** + **容错策略** + **Hang 检测** | 可主动发现任务长时间无进展的卡住问题。Hang 检测通常会避开任务刚启动后的初始化阶段,避免把数据加载、通信初始化或算子预热误判为卡住。 | 适合多机训练、通信挂起风险较高,并且能接受平台主动重启或重新提交的任务。 |
自动容错存在误判和漏判可能。对稳定性要求高、不能接受意外重启的任务,可以先只开启基础重试,或谨慎开启更激进的容错策略。对于显存溢出、代码错误、数据路径错误等需要修改配置或脚本才能解决的问题,自动重试通常无法根治。
## 配置自动容错
创建训练任务时,可在 **高级选项** 中开启 **自动容错**,并设置任务级重试预算。该预算用于控制任务失败后自动重新提交的次数;原地进程重启、节点规避或诊断动作是否发生,取决于当前任务类型、容错策略和平台能力。
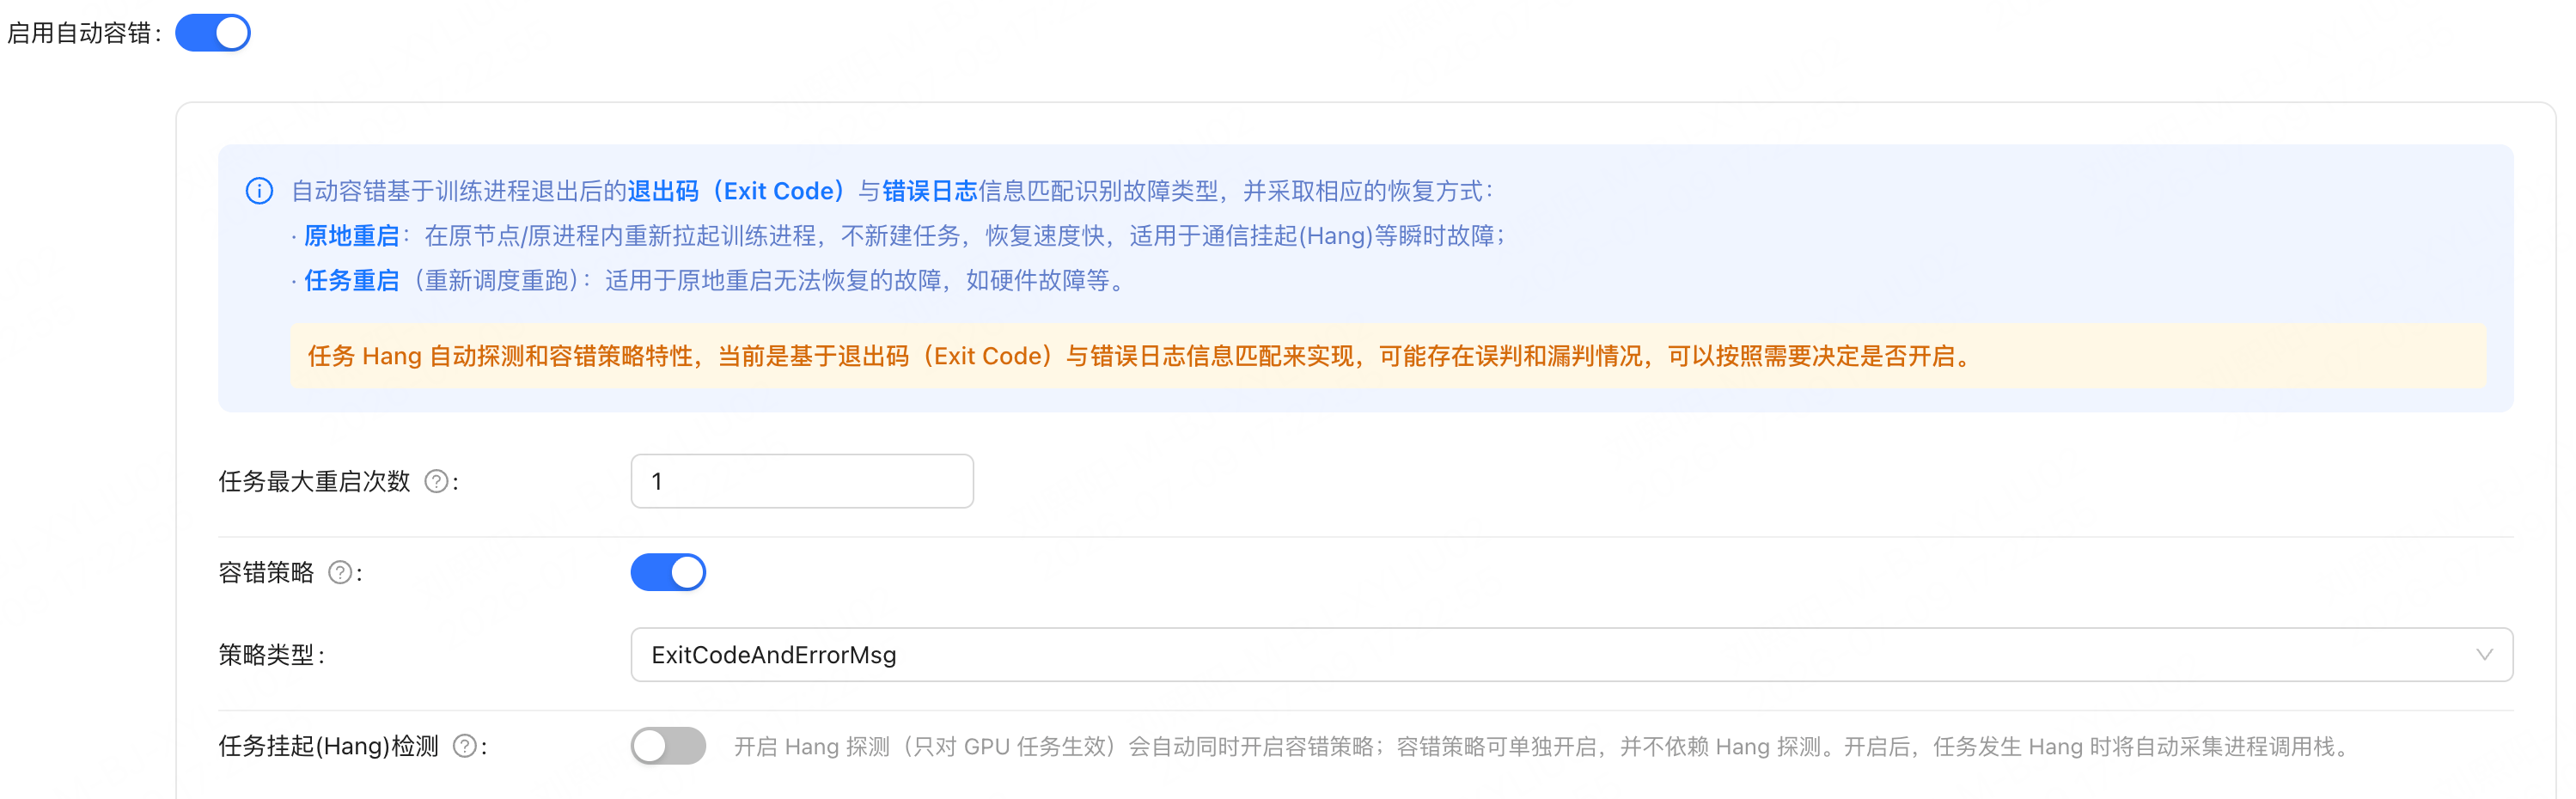 | 配置项 | 说明 |
| ----------------- | ---------------------------------------------------------------------- |
| **自动容错** | 开启后,平台可在任务异常时按策略重新提交、重启或恢复任务。 |
| **任务最大重启次数** | 控制任务级自动重新提交预算。任务达到预算后仍无法恢复时,需要先查看故障记录和日志,再决定是否修改配置后手动重提。 |
| **策略类型** | 平台会根据退出码和错误信息选择恢复动作。关闭容错策略时,相关 Hang 检测能力也可能不可用。 |
| **任务挂起(Hang) 检测** | 可用于检测进程未退出但长期无进展的情况。配置检测间隔和判定时长时,应避开模型加载、数据准备、评估和分布式初始化等正常耗时阶段,降低误判风险。 |
如果需要在任务退出前通知训练程序保存状态,可在 PyTorchJob 中接入 **退出 checkpoint 通知**。训练程序需要实现 `/v1/preempt/notify` 和 `/v1/preempt/status`,用于接收保存通知并返回保存结果;创建任务时按页面展示配置程序监听端口。
退出 checkpoint 通知不能替代周期性 checkpoint。节点断电、进程异常退出等场景可能无法完成退出前通知;正式长时间训练仍应定期把模型、优化器、学习率调度器、训练步等必要状态写入持久化 Volume。
## 查看容错重试链
开启自动容错后,可以在任务详情页的 **容错详情** 中查看原任务和重试任务的状态、故障说明、起止时间和处理结果。
查看时重点关注:
* 哪一次重试开始失败。
* 故障是否集中在某个节点或某类错误。
* 是否已达到最大重试次数。
* 任务是否进入容错停止或容错失败状态。
* 重试任务是否已经使用新的节点、配置或恢复动作。
查看重试链后,还需要进入最新一次尝试的日志,确认训练脚本已经加载 checkpoint,并且训练步、指标或输出文件继续推进。只看到平台重新提交任务,不等于业务训练进度已经恢复。
## 故障类型和处理方式
平台会根据日志和错误信息匹配故障类型。故障分类用于辅助判断和恢复,不等同于确诊根因。
| 故障类型 | 常见含义 | 处理建议 |
| ------------ | ---------------------------------- | --------------------------------------- |
| `HW_NODE` | GPU、硬件、驱动、ECC、Xid、段错误等硬件或节点相关异常。 | 查看事件和日志,必要时使用 Bisect Diagnose 定位节点。 |
| `NET_FABRIC` | NCCL、InfiniBand、RDMA、RoCE 或网络通信异常。 | 查看多机通信日志和监控,必要时使用 Bisect Diagnose。 |
| `OOM_HOST` | 主机内存不足或容器被系统终止。 | 调整数据加载、内存配置或实例规格。 |
| `OOM_GPU` | GPU 显存不足。 | 降低 batch size、调整模型配置或使用更大规格。自动重试通常无法解决。 |
| `COMM_HANG` | 通信挂起或多机训练长时间无进展。 | 查看日志和监控,按需启用 Hang 检测或 Bisect Diagnose。 |
| `APP_ERROR` | 训练代码异常。 | 查看用户日志,修复代码或参数后重新提交。 |
| `ENV_ERROR` | 镜像、依赖、环境或外部访问异常。 | 检查镜像、依赖安装、启动命令和网络访问。 |
| `UNKNOWN` | 未匹配到已知类型。 | 结合状态、事件、日志和监控继续排查。 |
## 判断恢复结果
排查自动容错时,先判断平台采取了哪类动作,再确认训练是否真正恢复。
| 动作 | 查看位置 | 判断重点 |
| --------- | ---------------------------- | ------------------------------ |
| 原地重启 | 当前任务的容器日志和事件。 | 进程是否重新启动,是否加载了预期 checkpoint。 |
| 重新提交 | 容错详情中的关联重试任务。 | 新任务是否获得资源,是否继续从 checkpoint 推进。 |
| 故障节点规避或诊断 | 容错详情、事件和 Bisect Diagnose 记录。 | 是否排除了疑似节点,是否导致新的排队条件。 |
| 快速失败或预算耗尽 | 容错详情和故障说明。 | 是否需要先修复代码、镜像、数据路径或资源配置,再手动重提。 |
恢复后的最新尝试进入运行中后,还需要继续验证业务训练进度:
* 在日志中确认训练脚本加载了预期 checkpoint。
* 比较恢复前后的训练步、loss 或业务指标,确认训练继续推进。
* 检查新的 checkpoint 和输出文件是否写入成功。
* 记录原任务 ID、最新尝试 ID、恢复动作、checkpoint 路径和关键日志,便于后续排查。
## 相关文档
* [训练任务高级配置](./advanced-training-task-configuration)
* [排查训练任务问题](./troubleshoot-training-tasks)
* [使用 Bisect Diagnose 诊断训练故障节点](./diagnose-training-failures-with-bisect)