自动容错如何工作
自动容错通常按以下链路工作:- 健康检测:平台监测进程退出、GPU / 硬件错误、通信挂起等异常,并根据日志和错误信息做故障分类。开启容错后,平台通常会在训练正式开始前执行启动前健康检测,用于提前发现节点或通信环境异常。
- 故障处置:根据故障类型尝试原地重启、重新提交、隔离疑似故障节点或触发二分诊断等动作;具体支持范围以当前平台能力为准。
- 自动重试:在最大重试次数内拉起新的重试任务,形成原任务和各次重试任务组成的容错重试链。
选择容错模式
基础容错可用于 PyTorchJob 和 RayJob;容错策略和 Hang 检测主要面向 PyTorchJob。具体可选项以创建训练任务时的 高级选项 为准。
自动容错存在误判和漏判可能。对稳定性要求高、不能接受意外重启的任务,可以先只开启基础重试,或谨慎开启更激进的容错策略。对于显存溢出、代码错误、数据路径错误等需要修改配置或脚本才能解决的问题,自动重试通常无法根治。
配置自动容错
创建训练任务时,可在 高级选项 中开启 自动容错,并设置任务级重试预算。该预算用于控制任务失败后自动重新提交的次数;原地进程重启、节点规避或诊断动作是否发生,取决于当前任务类型、容错策略和平台能力。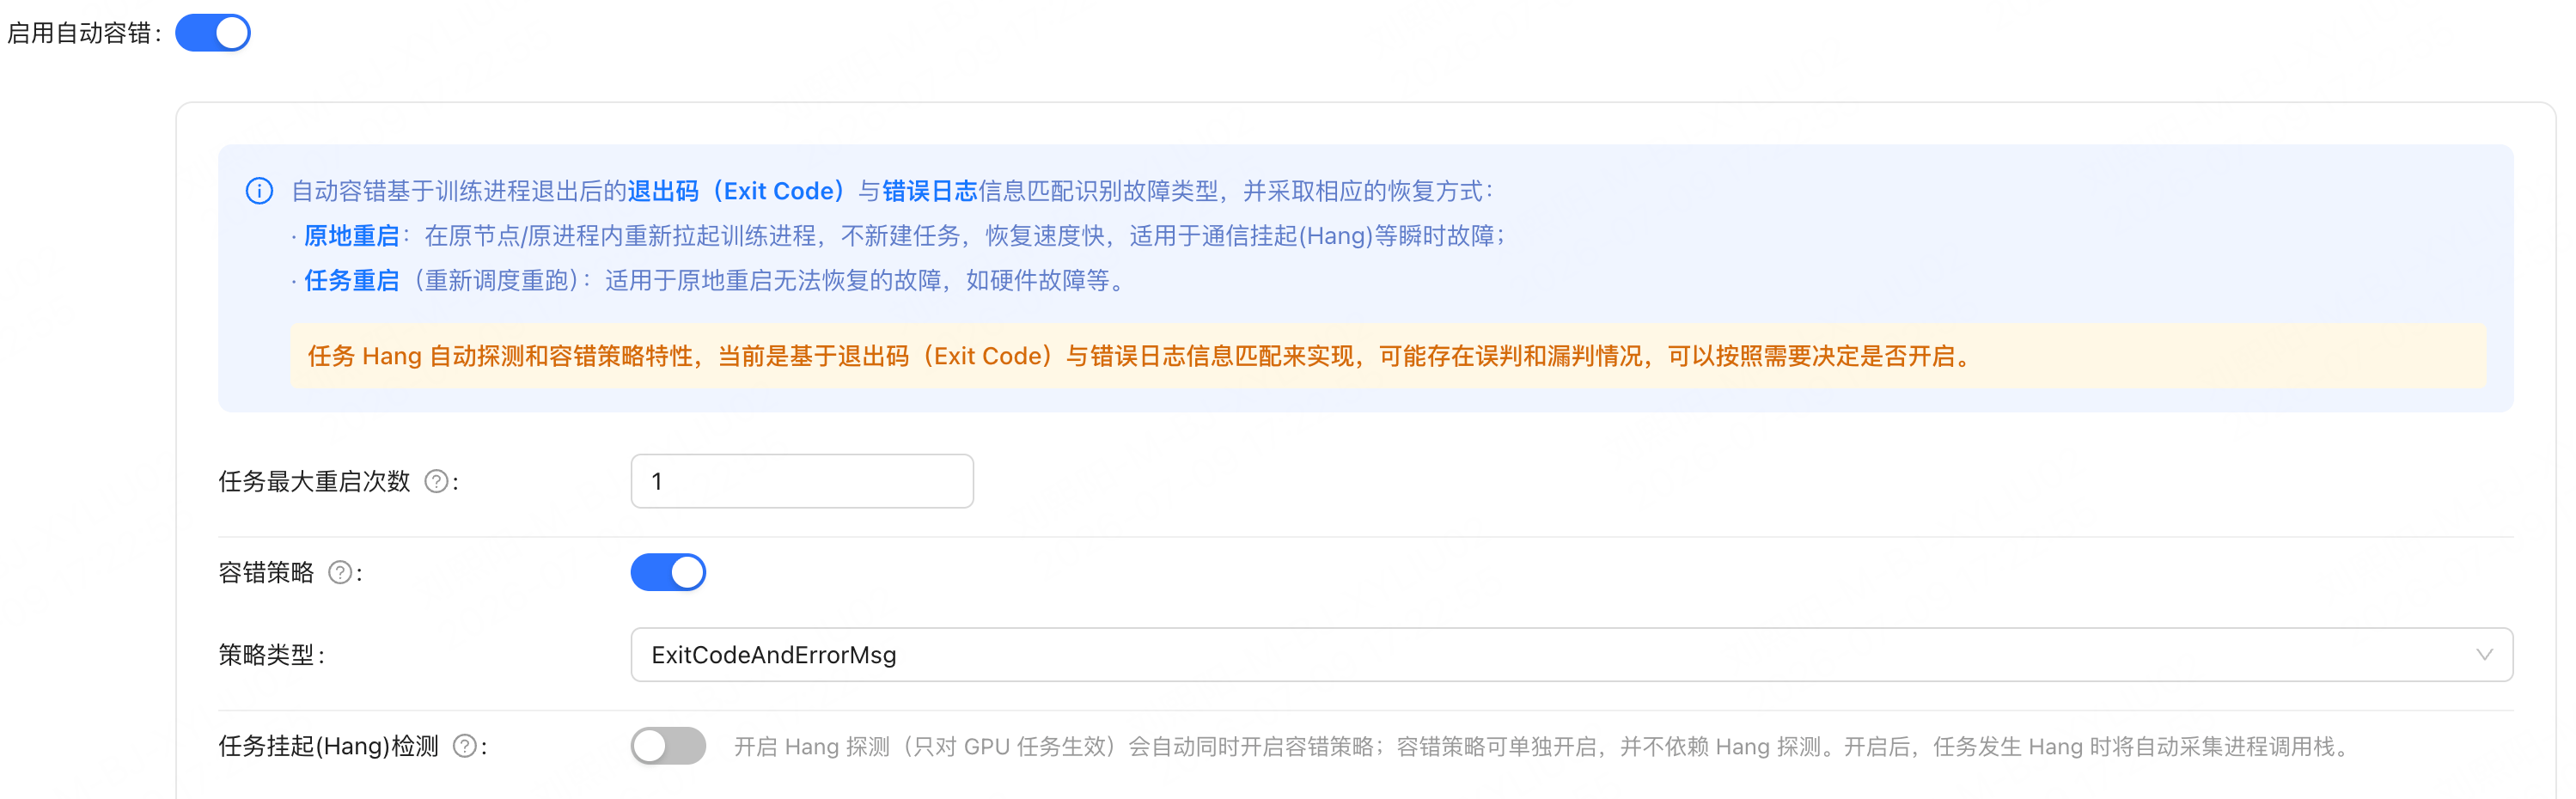
如果需要在任务退出前通知训练程序保存状态,可在 PyTorchJob 中接入 退出 checkpoint 通知。训练程序需要实现
/v1/preempt/notify 和 /v1/preempt/status,用于接收保存通知并返回保存结果;创建任务时按页面展示配置程序监听端口。
查看容错重试链
开启自动容错后,可以在任务详情页的 容错详情 中查看原任务和重试任务的状态、故障说明、起止时间和处理结果。 查看时重点关注:- 哪一次重试开始失败。
- 故障是否集中在某个节点或某类错误。
- 是否已达到最大重试次数。
- 任务是否进入容错停止或容错失败状态。
- 重试任务是否已经使用新的节点、配置或恢复动作。
故障类型和处理方式
平台会根据日志和错误信息匹配故障类型。故障分类用于辅助判断和恢复,不等同于确诊根因。判断恢复结果
排查自动容错时,先判断平台采取了哪类动作,再确认训练是否真正恢复。
恢复后的最新尝试进入运行中后,还需要继续验证业务训练进度:
- 在日志中确认训练脚本加载了预期 checkpoint。
- 比较恢复前后的训练步、loss 或业务指标,确认训练继续推进。
- 检查新的 checkpoint 和输出文件是否写入成功。
- 记录原任务 ID、最新尝试 ID、恢复动作、checkpoint 路径和关键日志,便于后续排查。