
扩缩容
推理服务支持手动扩缩容和弹性扩缩容。扩容前确认资源池配额;缩容前确认剩余容量可以承接当前流量、长连接和流式请求。
按指标扩缩容前,先确认服务的 Prometheus 指标端点能够返回数据:指标端口应为正数,指标路径应以
/ 开头。配置规则时,重点核对 采集间隔、窗口、计算方式、角色、指标、标签、阈值、持续时间、Pod 聚合、最小副本、最大副本、扩缩步长、冷却时间 和 指标不可用策略。缺失指标不代表负载为 0,应按页面策略跳过、沿用上次值或执行回退处理。
按时间扩缩容时,核对时间点、目标角色、目标副本、时区、跨日规则和最低服务容量,并为资源等待和模型预热预留时间。最大副本数只是调整上限,平台不会因此提前预留资源。
如果服务中任一角色使用 variants 多实例组配置,整个服务不能启用指标窗口扩缩容。手动调整后,自动策略可能再次修改目标副本;固定容量排障或压测前,应明确自动策略是否需要暂停。
监控和告警
推理服务可采集资源指标和引擎指标。资源监控用于查看 CPU、GPU、显存、内存和网络使用情况;引擎监控用于查看 vLLM、SGLang 等引擎的请求、延迟和吞吐相关指标。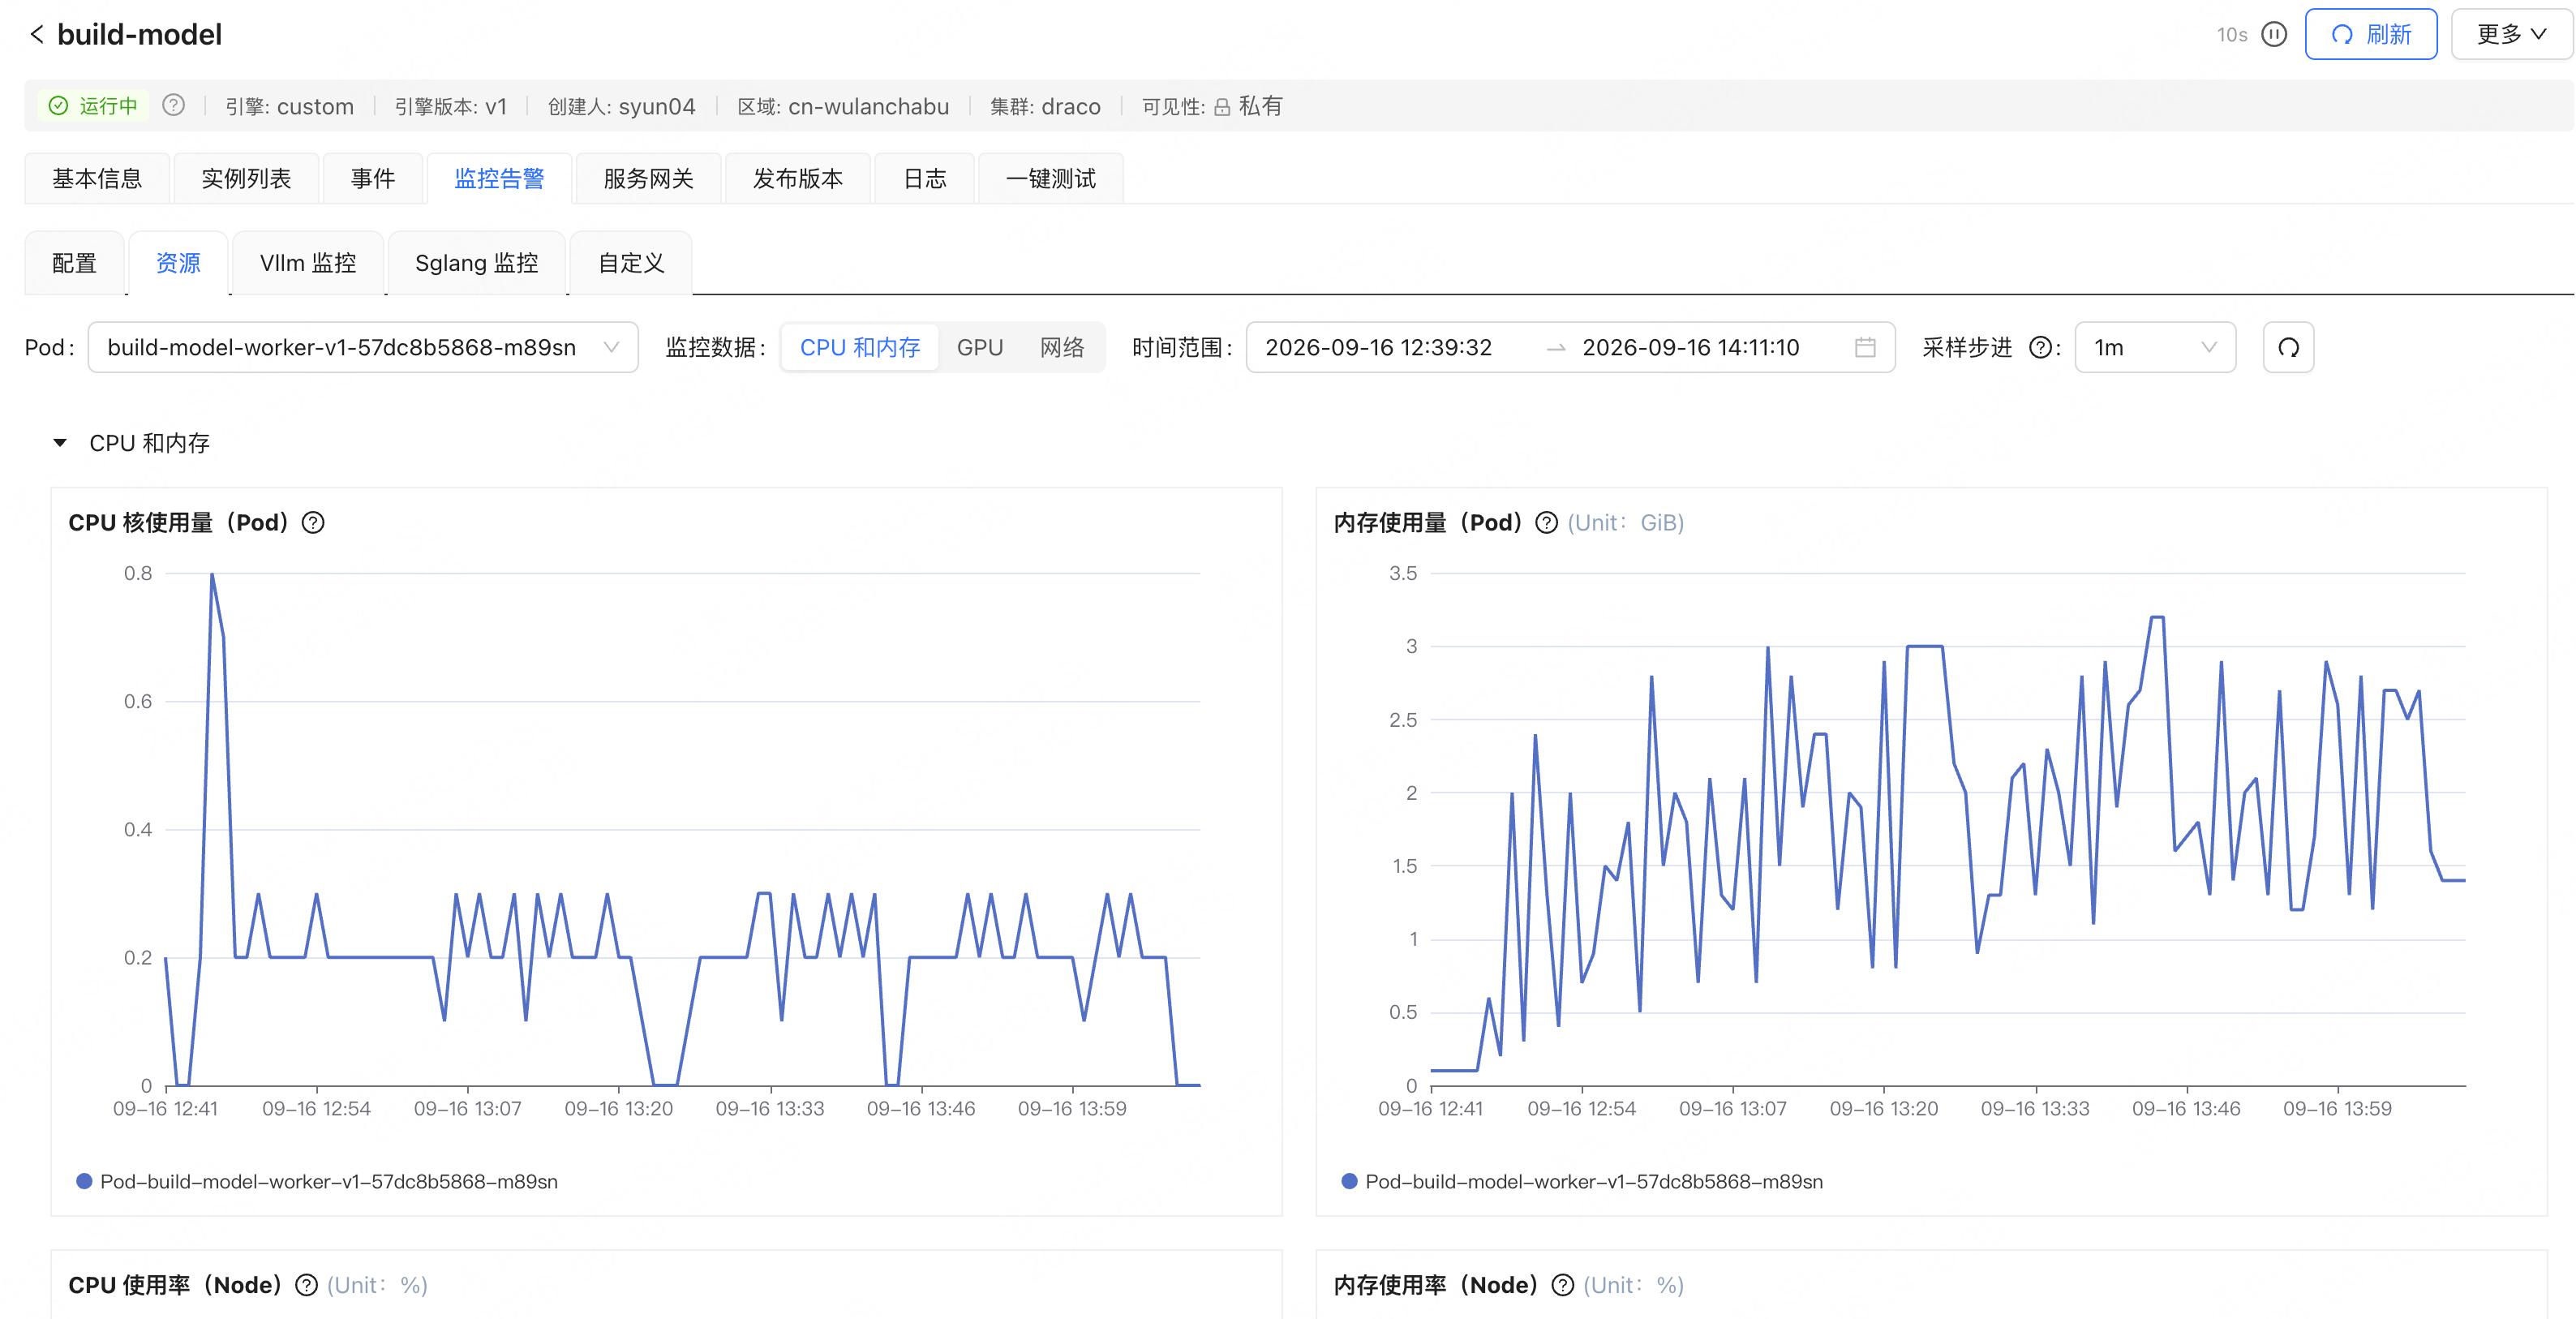
当前服务异常类告警以控制台可订阅项为准。如果需要监控自定义指标,请先确认服务已暴露 Metrics 路径和端口。
优先级和抢占
创建大模型推理服务时,可以在 高级配置 中设置 优先级 和 可被抢占。优先级用于设置服务的调度优先级;可被抢占用于设置服务是否允许被抢占。 配置入口和其他高级参数,请参见 创建大模型推理服务。发布和测试
智能路由、分布式 KV Cache 和自定义监控看板等能力会受引擎、集群和服务配置影响。页面提供对应配置入口时,再按业务目标启用;没有确认入口和字段前,不建议把这些能力写成固定操作路径。